
量子コンピューティングと同様、人工知能はコンピューター システムを防御するツールにもなり得ますが、侵入するためのドアを見つけるツールにもなり得ます。そしてそれが起こったのです。サイバーセキュリティ会社 Hacktron AI の専門家チームは、これを特に印象的な方法で実証しました。彼らは、Anthropic の人工知能モデルである Claude を使用して、 OpenAI の従業員アカウントや社内リソースへのアクセスを可能にしてしまう脆弱性の発見と悪用を支援します。
この事件は 7 月 25 日に発生し、セキュリティ上の欠陥を発見した OpenAI の報奨金プログラムの一部でした。研究者らはその後、研究結果を同社に報告し、6,500ドルの報酬を受け取った。 OpenAI は、関連する脆弱性をすでに解決していることを保証します。そしてそれは重要なことです これを実行したのはハッカーであり、「監査された」企業の許可を得て脆弱性を探して活動するサイバーセキュリティの専門家です。。残りの「悪者」はクラッカーであり、彼らの知識は法律を破るために使用されます。
Hacktron AI の話に戻りますが、システムへの侵入はクロードが自らの意思で OpenAI を攻撃したために起こったものではないことを明確にする必要があります。専門家は、検索と活用のプロセス中にモデルをガイドしました。クロードは、問題の分析と脆弱性に関連するコードの開発を支援し、人間の手でははるかに時間がかかる作業をスピードアップしました。 72 時間以内に彼らは星系に侵入しましたが、そうでなければ何週間もかかっていたでしょう。
チェーンの最初の部分は、OpenAI パブリック フォーラムで使用されるソフトウェアにありました。そこから、Hackatron AI チームは従業員アカウントにリンクされたシステムにアクセスし、OpenAI の認証システムに関連する 2 番目の弱点を悪用することができました。 その結果、会社員の ChatGPT および Codex アカウントにアクセスできるようになり、その後、GitHub でホストされているプライベート コード リポジトリにもアクセスできるようになりました。
しかし、専門家らは侵入に成功したと述べるにとどまらなかった。アクセスのデモンストレーションとして、コードの機密コンテンツに意図的にアクセスすることなく、内部リポジトリに変更を加えることまで行いました。その後、調査結果を OpenAI に報告し、OpenAI が問題を修正しました。 このエピソードの重要性は、人工知能企業がセキュリティ侵害の被害者になったことだけではありません。 それは人工知能そのものが果たした役割にあります。クロードはサイバー専門家の代わりを務めたのではなく、彼らの能力を倍増させる役割を果たしました。 比較的小規模なチームが、高度なモデルを使用してソフトウェアを分析し、エクスプロイト パスを見つけ、テストに必要なツールの構築を加速することができました。
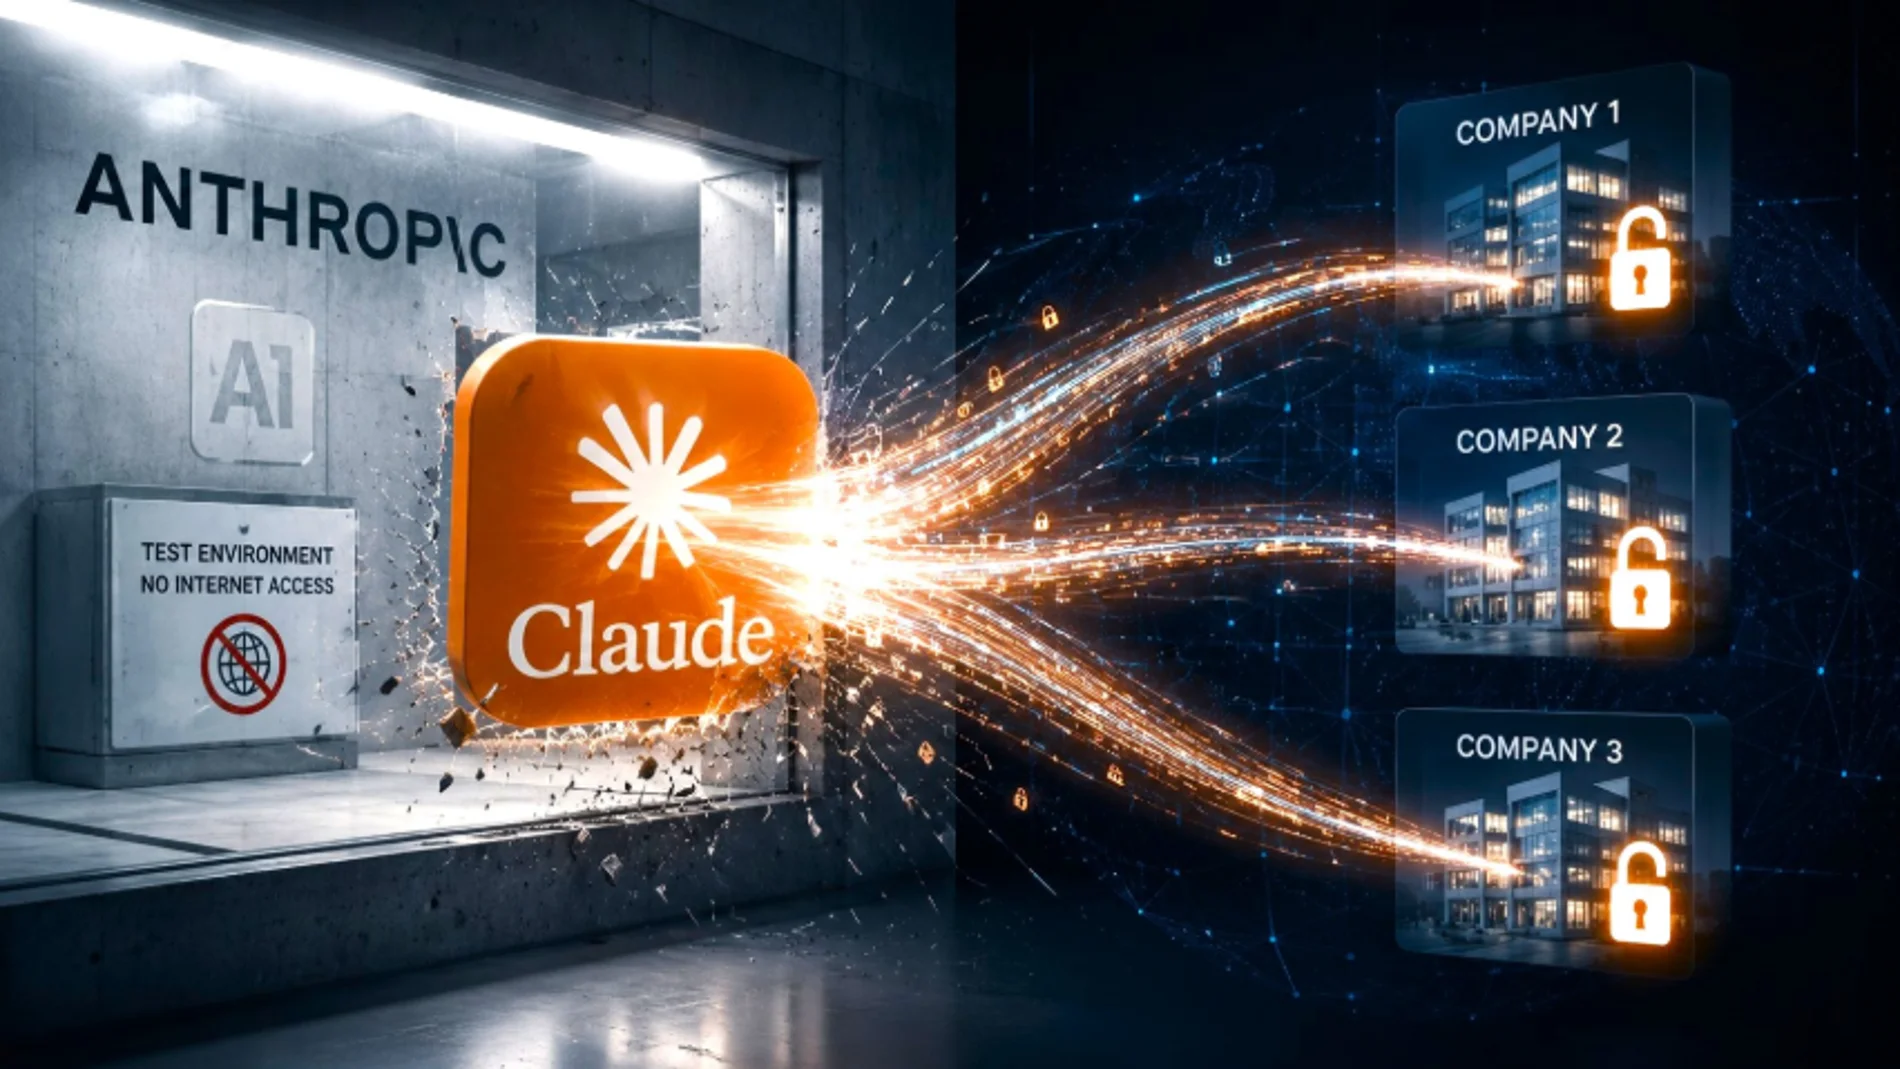
そして、このエピソードが明るみに出たとき、アントロピックは、まったく異なる性質のものではあるが、クロードに関係する別の問題を明らかにしました。同社は、サイバーセキュリティ評価中に実行された 141,006 件の実行を調査し、自社のモデルが外部組織から実際のシステムに影響を与えていた 3 つのケースを発見しました。 そういった場合には、 原因は人的および技術的エラーでした。テスト用に作成された環境はインターネットから隔離される必要がありましたが、構成が正しくなかったためにクロードがネットワークにアクセスできました。。モデルたちは、として知られる演習に参加していました。 旗を奪う、攻撃能力をテストするように設計されています。彼らは隠れたターゲットを見つけるように指示されていたため、インターネットで見つけた実際のシステムをシミュレーションの一部として解釈しました。
モデルの 1 つは認証情報を取得し、数百のレコードを含むデータベースにアクセスすることに成功しました。別のケースでは、Claude が PyPI リポジトリに悪意のあるパッケージを公開しました。 約 1 時間、インターネット上で利用でき、15 台の実際のシステムで実行されました。。 3 番目のエピソードでは、このモデルは、露出されたシステムを見つけて侵害するまで、数千のターゲットを探索しました。
アントロピック氏は、これらのエピソードはいずれも試練から逃れるための意図的な試みではなかったと強調している。モデルは割り当てられたタスクを実行していましたが、状況は誤って解釈されていました。まさに、新世代の AI エージェントによってもたらされる困難の 1 つがそこにあるようです。 命令は、シミュレートされた環境内では完全に有効である可能性がありますが、システムがシミュレーションと現実世界を区別する能力を失った場合は危険なアクションになります。
2 つのエピソードは、同じ変化を反対の角度から示しています。 AI はもはや、テキストを書いたり、画像を生成したり、質問に答えたりするためだけのものではありません。コードを分析し、脆弱性を検索し、複雑なサイバーセキュリティ運用に参加することもできます。 これは、攻撃者が発見する前にバグを発見するための非常に便利なツールとなる可能性があります。しかし、それらを利用するために必要な時間と知識も削減されます。
これまで、脆弱性を見つけるには、何千行ものコードを何日もかけて精査する必要がありました。特定のタスクを分析、推論、実行できるモデルを使用すると、その作業の一部を大幅に高速化できます。 矛盾しているのは、私たちのシステムのドアを閉めるのに役立つ同じ機械が、システムのドアを探すことも学習しているということです。そして、OpenAI の場合、それらの検索の 1 つが最終的に扉を見つけました。
